MACHINE LEARNING & OPTIMIZATION · 2025
Statistical Learning & Zeroth-Order Optimization
Dalla teoria del rischio predittivo alla classificazione: sette esperimenti riproducibili per confrontare regressione, gradient descent e ottimizzazione senza gradienti.
ESPLORA IL CODICE SU GITHUB ↗01 / LA DOMANDA
Un algoritmo può imparare bene anche quando il problema è più complicato del modello?
Immagina di voler prevedere un risultato a partire da alcune variabili. Puoi raccogliere più osservazioni, scegliere un modello più flessibile oppure cambiare il modo in cui lo addestri. Ma quale di queste scelte risolve davvero il problema?
Ho affrontato questa domanda attraverso esperimenti progressivi: prima la regressione, poi l'ottimizzazione con e senza gradienti, infine una classificazione su un dataset pubblico. Il punto non è trovare un numero più alto, ma capire perché un metodo funziona, quando fallisce e cosa significa confrontarlo correttamente.
Il lavoro nasce da un'esercitazione ENSAI del 2025. Questa pagina racconta una successiva ricostruzione riproducibile in Python, con test, correzioni metodologiche e approfondimenti documentati.
02 / PRIMA SCOPERTA · LA SCELTA DEL MODELLO
Più dati non bastano se il modello non sa descrivere la realtà.
Nei dati simulati, una variabile influenza la risposta in modo lineare, mentre un'altra contribuisce solo quando assume valori positivi: è una relazione con una soglia, descritta dalla funzione ReLU.
GRAFICO ORIGINALE · ESPERIMENTO PYTHON
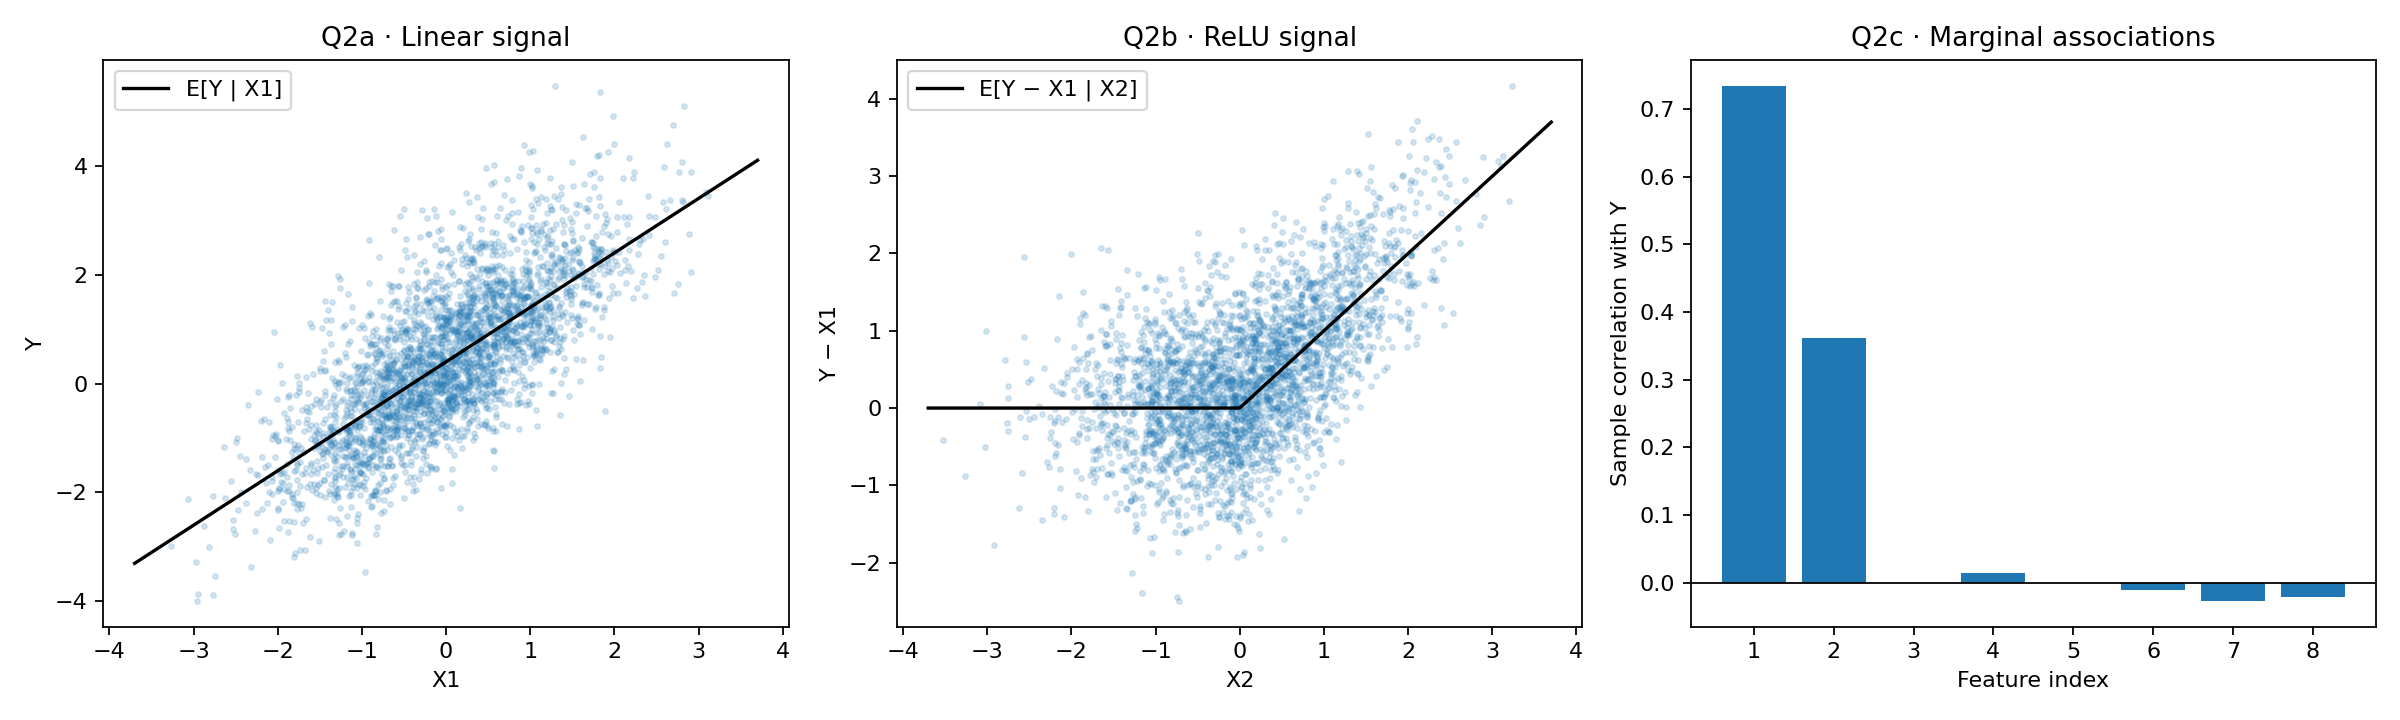
Ho quindi confrontato due modelli addestrati con lo stesso tipo di algoritmo senza gradienti: uno lineare e uno che include una componente ReLU. La metrica è la MSE, l'errore quadratico medio sulle previsioni: più è bassa, meglio è.
GRAFICO ORIGINALE · ESPERIMENTO PYTHON
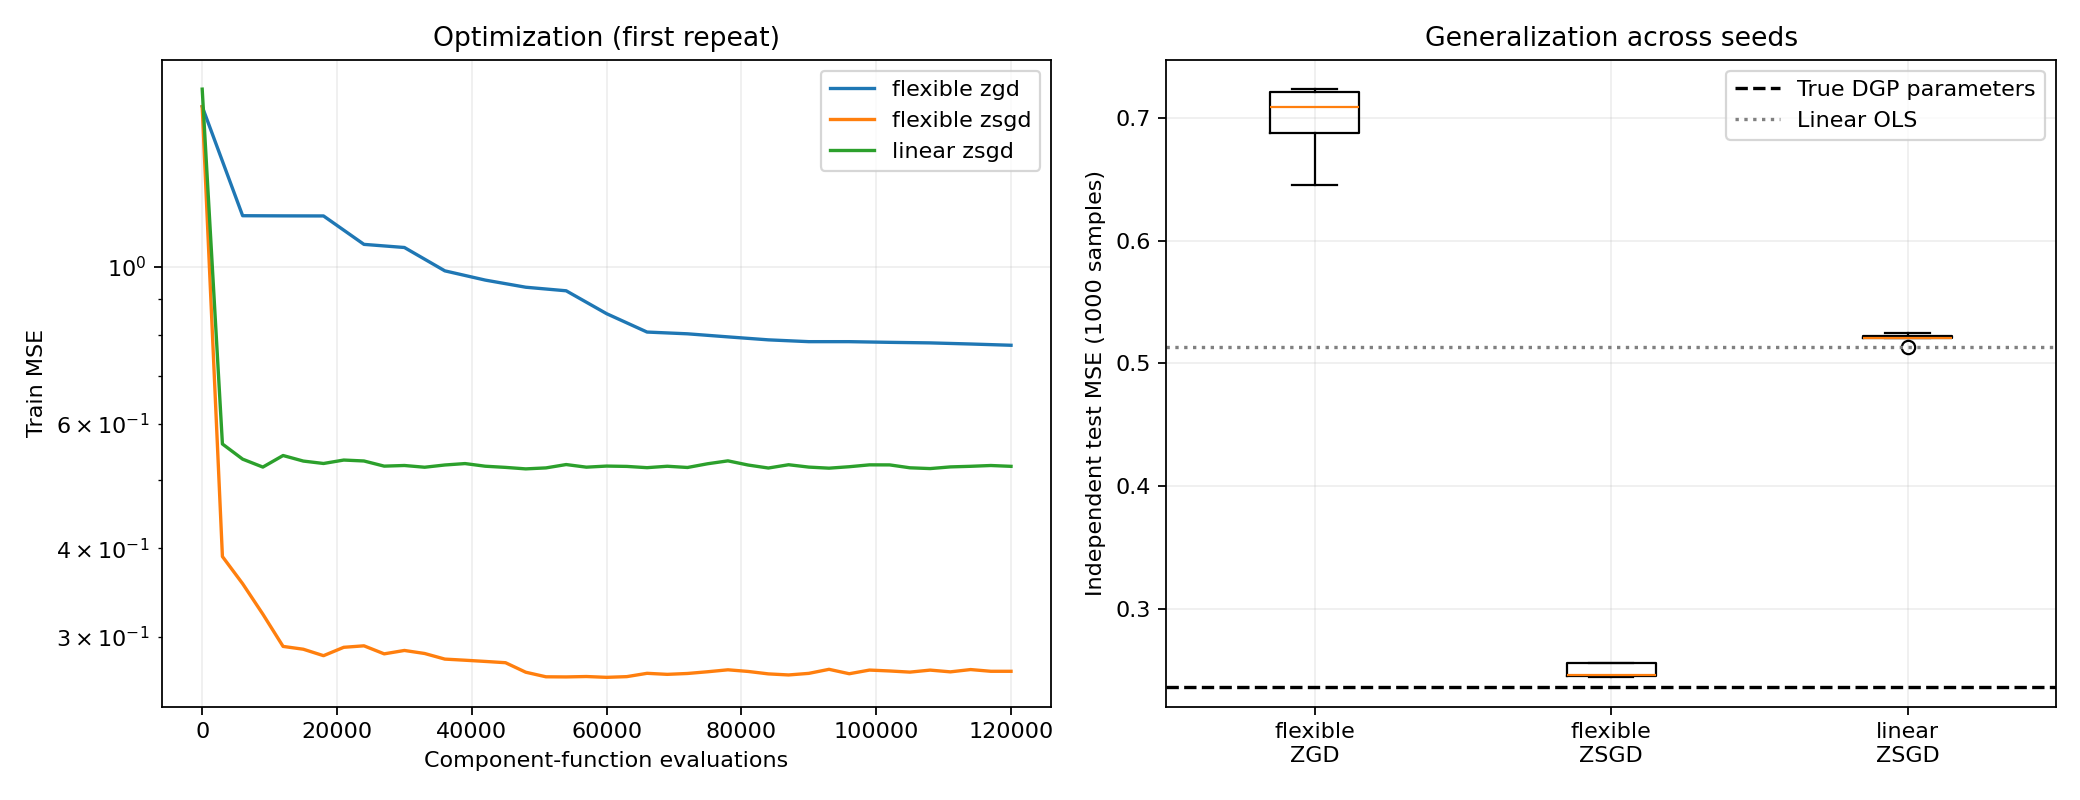
Nel test, l'errore mediano del modello flessibile è circa il 53% più basso. Non significa che i modelli complessi siano sempre migliori: qui la componente ReLU rappresenta proprio la struttura usata per generare i dati.
Il passaggio precedente del progetto mostra anche che la regressione lineare ha un errore di approssimazione teorico non nullo: aumentare il campione riduce l'incertezza della stima, ma non elimina da solo questa limitazione del modello.
03 / SECONDA SCOPERTA · COME SI IMPARA
E se non potessimo calcolare il gradiente?
Normalmente un algoritmo di ottimizzazione usa il gradiente per capire in quale direzione aggiornare i parametri. Ma in alcuni problemi possiamo valutare quanto è buona una soluzione senza avere accesso alle derivate.
GD e SGD
Usano derivate per aggiornare i parametri. GD considera l'intero campione; SGD lavora con osservazioni estratte casualmente e può compiere più aggiornamenti a parità di valutazioni individuali del gradiente.
ZGD e ZSGD
Valutano la funzione in due punti vicini e stimano una direzione di miglioramento. È una strategia utile quando il gradiente non è disponibile, ma può introdurre molta variabilità.
Nel progetto ho implementato e confrontato questi algoritmi controllando il numero di valutazioni richieste. Ho anche studiato come cambiano i risultati al variare del passo di aggiornamento e delle direzioni casuali utilizzate.
GRAFICO ORIGINALE · ESPERIMENTO PYTHON
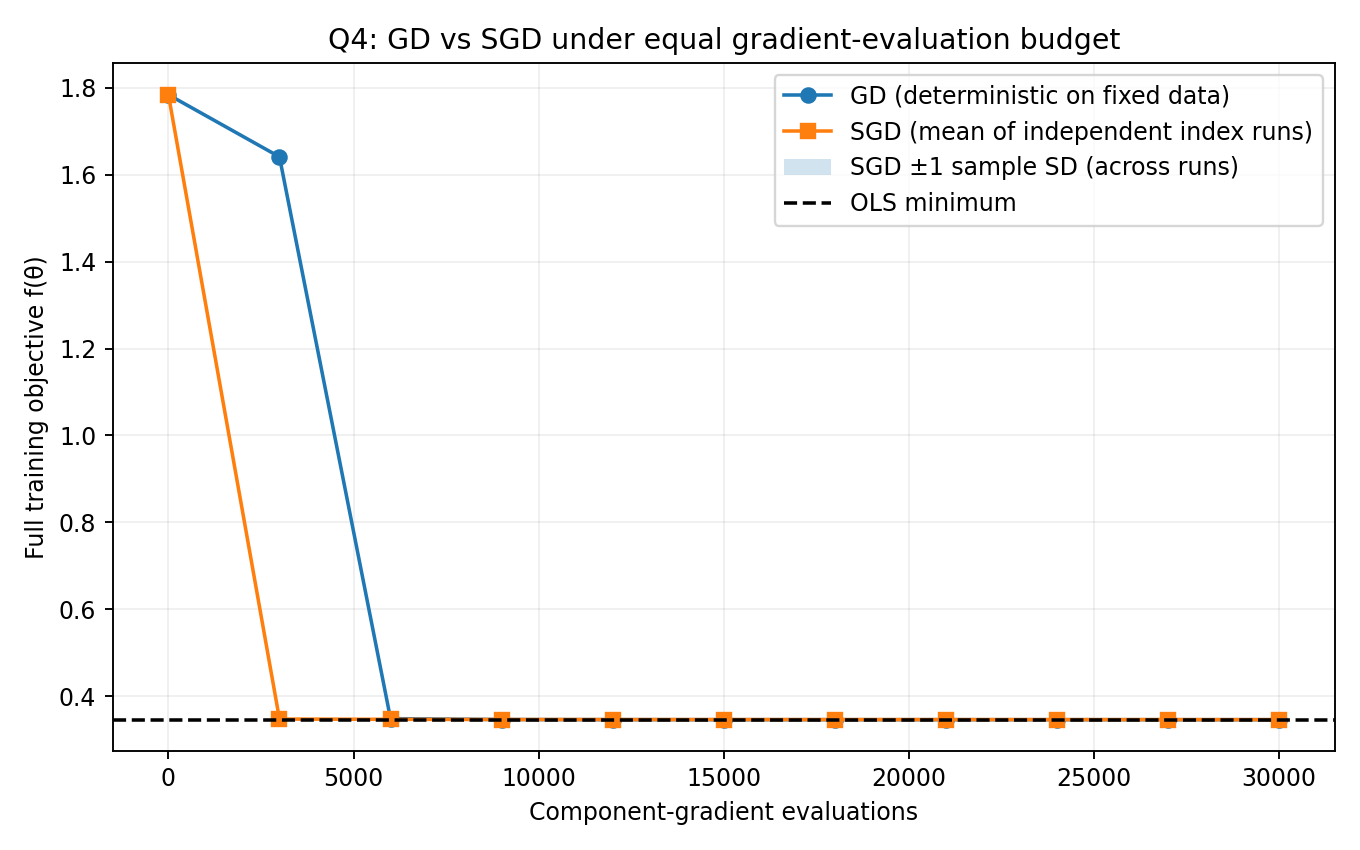
Entrambi i metodi arrivano vicino al minimo OLS. Le curve di convergenza nel repository raccontano invece come ci arrivano: GD con pochi aggiornamenti completi e SGD con molti aggiornamenti rumorosi.
GRAFICO ORIGINALE · ESPERIMENTO PYTHON
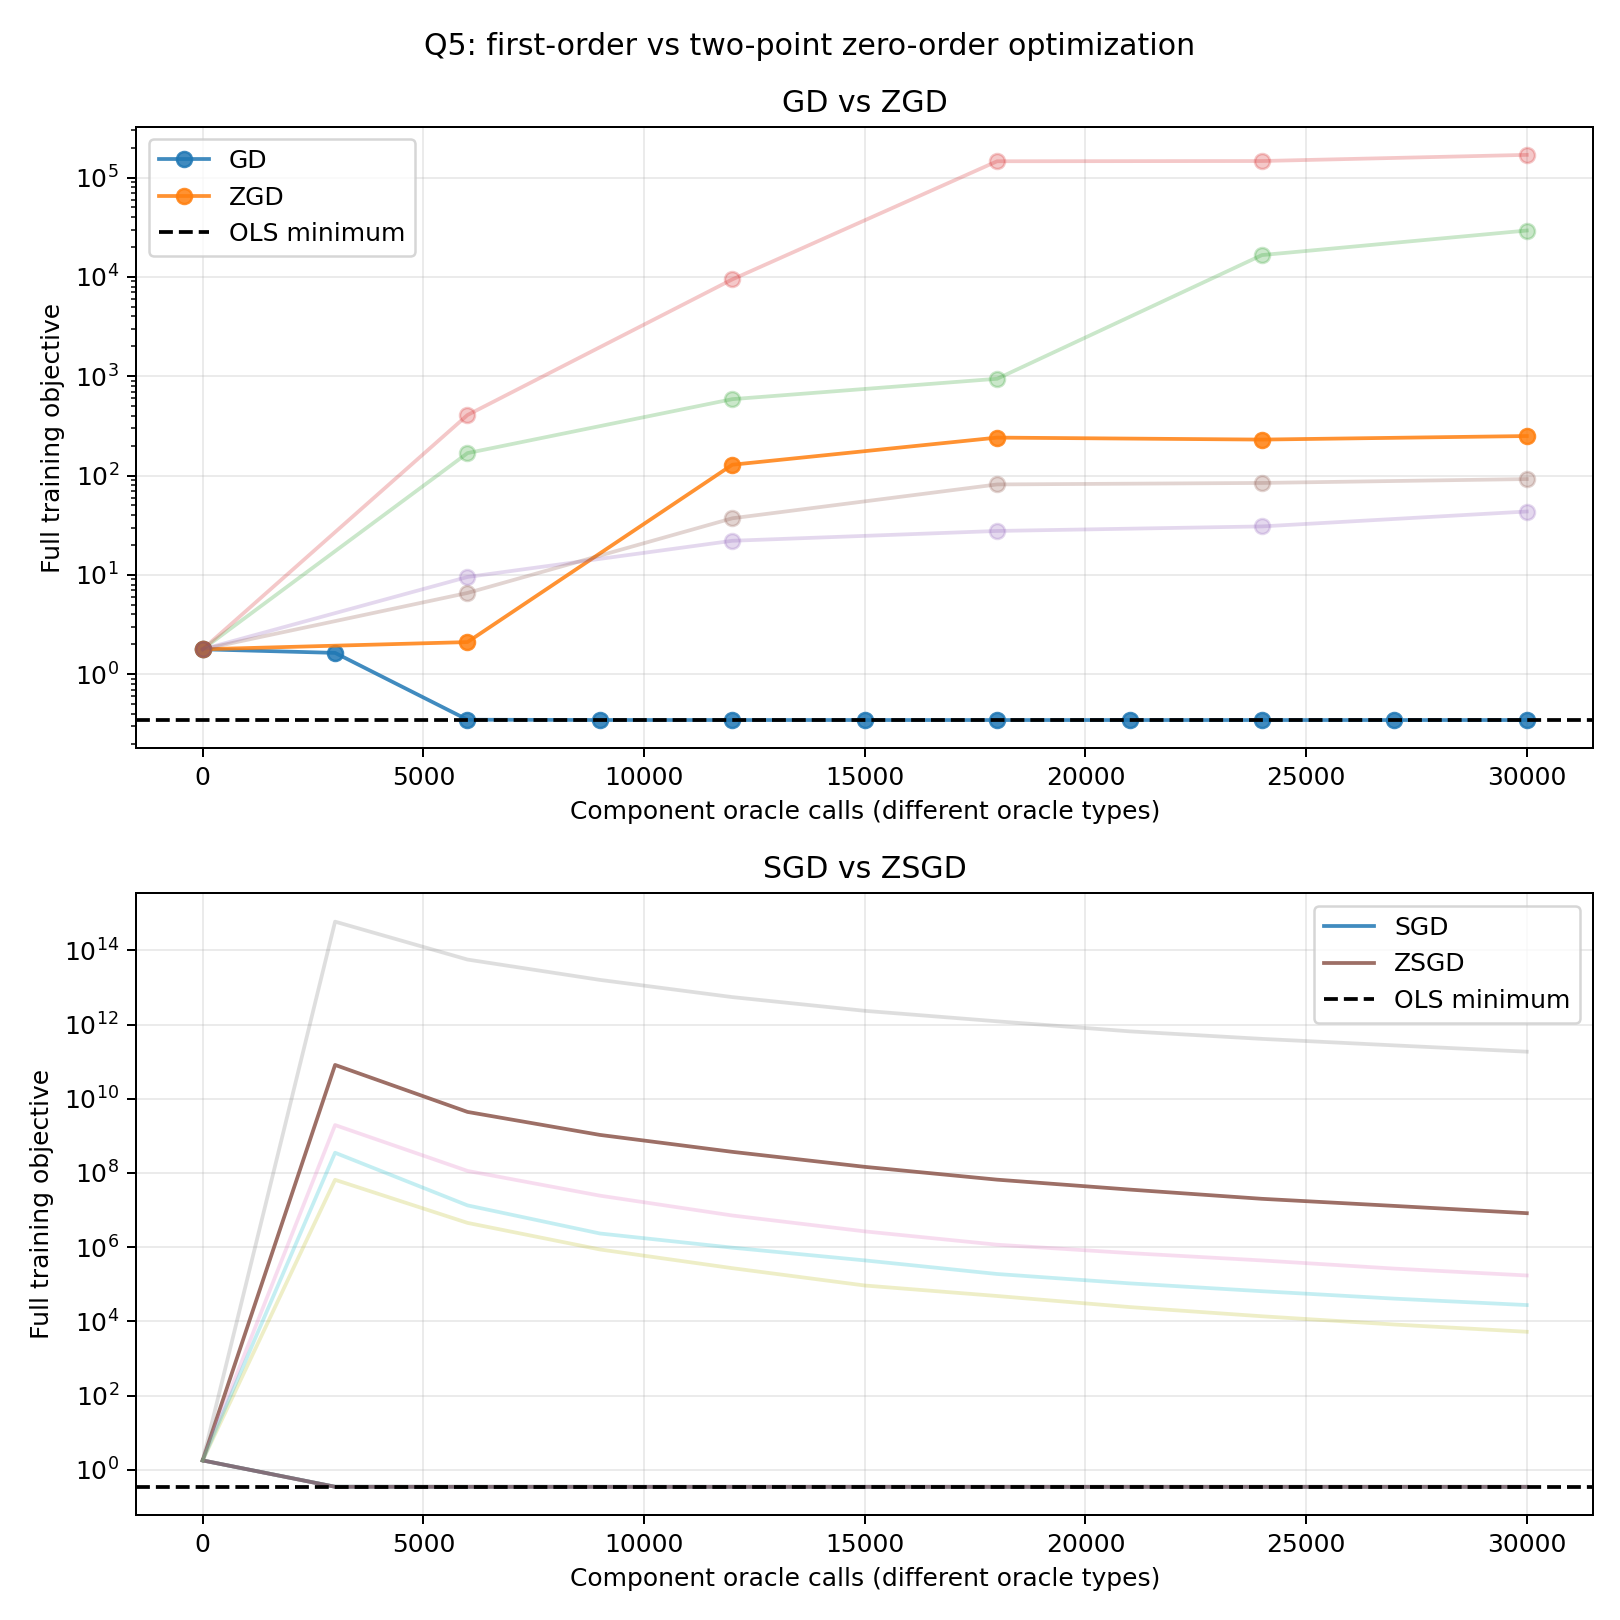
Una stima del gradiente matematicamente corretta non garantisce un addestramento stabile. Alcune configurazioni zeroth-order divergono. Ho mantenuto e documentato anche questi casi: capire i fallimenti è parte del lavoro sperimentale.
I budget di valutazioni di gradienti e di valori della funzione sono dichiarati separatamente: non equivalgono automaticamente allo stesso tempo di calcolo. I dettagli e le curve delle esecuzioni sono disponibili nel report sull'ottimizzazione.
04 / TERZA SCOPERTA · UN PROBLEMA DI CLASSIFICAZIONE
Un metodo senza gradienti può competere con un ottimizzatore standard?
Per la domanda bonus ho utilizzato il dataset pubblico UCI MAGIC Gamma Telescope: 19.020 eventi simulati descritti da dieci variabili numeriche. L'obiettivo è distinguere eventi gamma da eventi hadron.
Per isolare il più possibile l'effetto dell'ottimizzazione, ho confrontato la stessa famiglia di modelli, la regressione logistica, addestrata con L-BFGS oppure con ZSGD. I dati sono divisi in training, validation e test; la standardizzazione viene appresa soltanto sul training.
GRAFICO ORIGINALE · ESPERIMENTO PYTHON
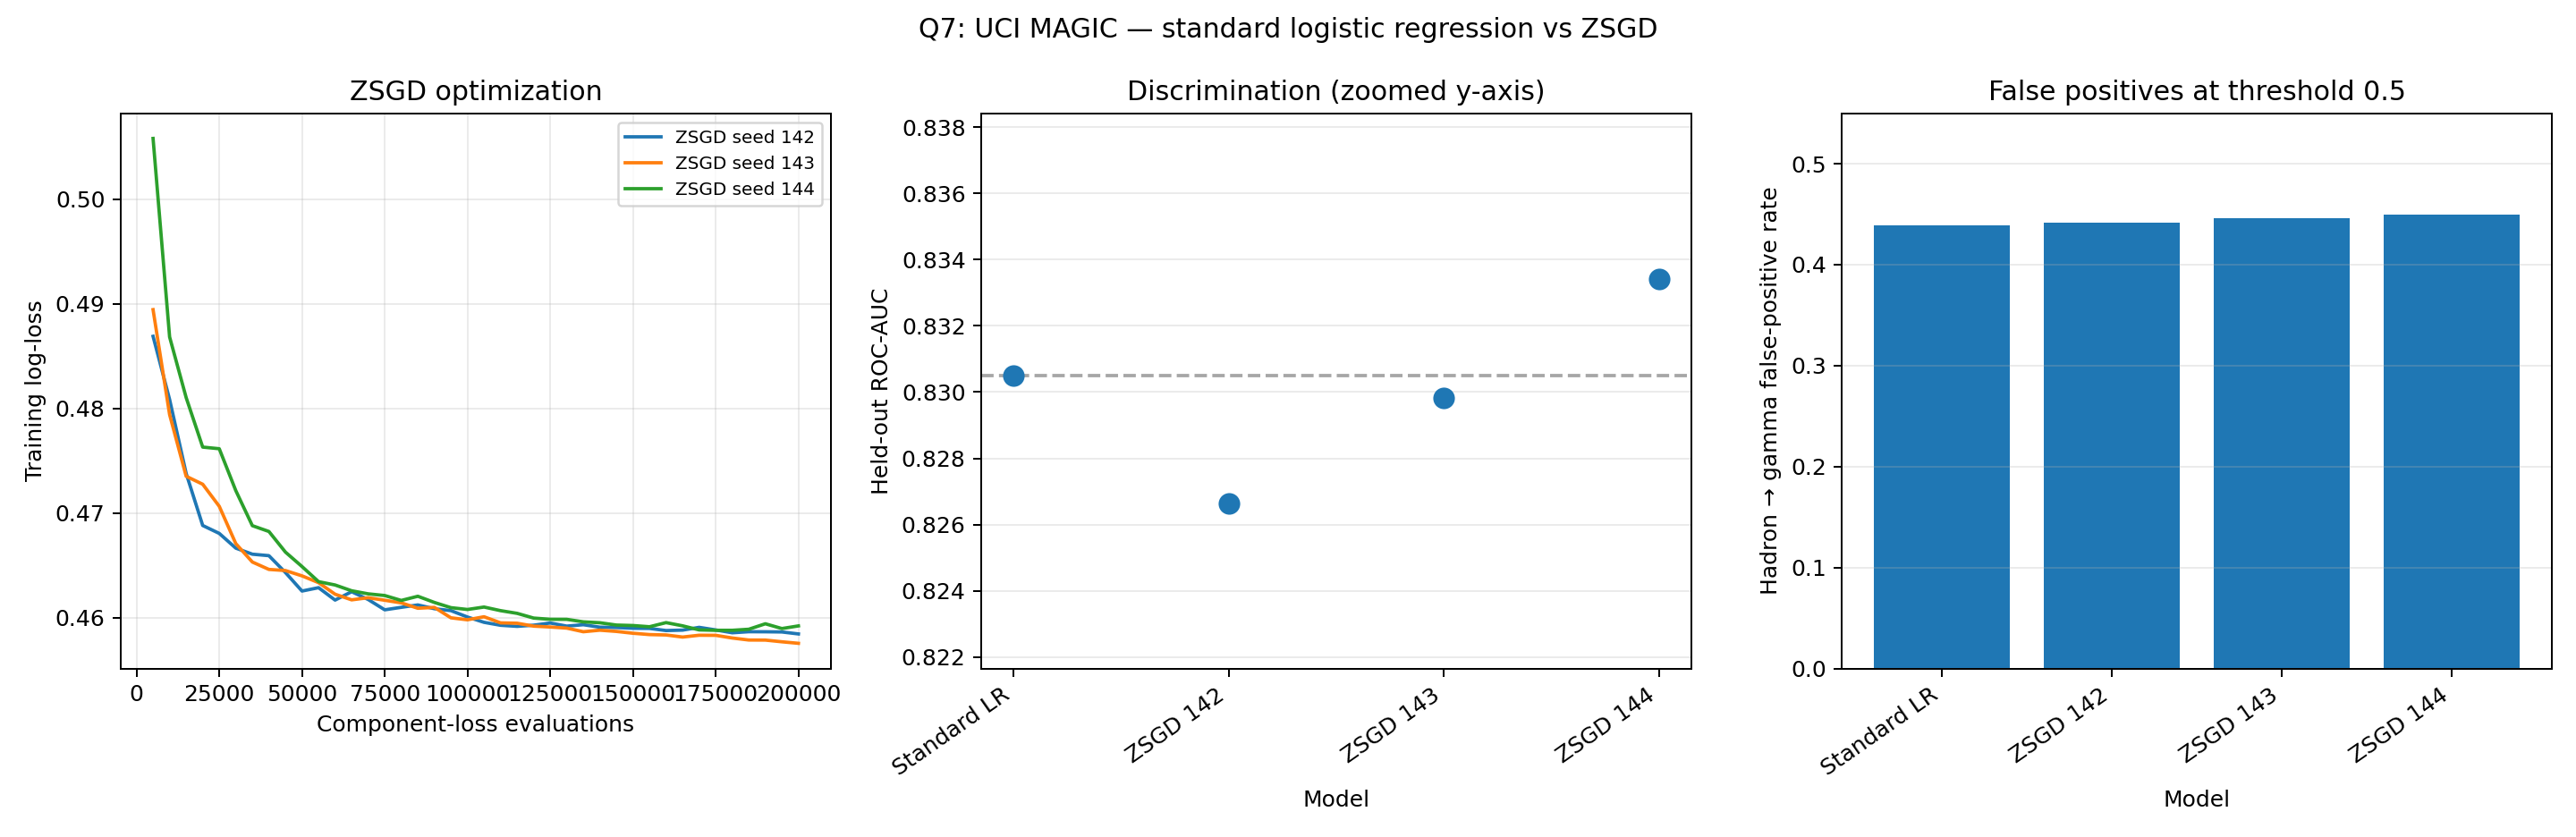
Il confronto dei falsi positivi chiarisce perché non basta dire «ROC-AUC circa 0,83»: quando si decide concretamente quali eventi classificare come gamma, la soglia scelta cambia il tipo e la quantità degli errori.
Le ROC-AUC sono molto vicine in questo esperimento. Questo mostra che ZSGD riesce ad addestrare il classificatore in condizioni definite, non che sia più veloce o generalmente preferibile a L-BFGS.
C'è anche un secondo punto: una buona ROC-AUC non basta per scegliere come usare un classificatore. Alla soglia 0,5, la baseline identifica erroneamente come gamma circa il 43,9% degli eventi hadron del test. In un'applicazione concreta bisognerebbe valutare soglie e costi degli errori.
MAGIC contiene eventi simulati, non osservazioni operative rappresentative di un deployment reale. Il confronto usa uno split fisso e tre seed ZSGD: non è una valutazione esaustiva della robustezza.
05 / COSA PORTO DA QUESTO PROGETTO
Non basta ottenere un risultato: bisogna saperlo spiegare.
Ragionamento statistico
Distinguere errore di stima, errore di approssimazione e qualità predittiva.
Implementazione
Tradurre algoritmi di ottimizzazione in Python e confrontarli con budget espliciti.
Valutazione critica
Non nascondere divergenze, variabilità o limitazioni del protocollo sperimentale.
Riproducibilità
Organizzare codice, test, dipendenze, report e verifiche automatiche per rendere ispezionabile il lavoro.
IN SINTESI
Tre esperimenti, una lezione: il contesto dà significato ai numeri.
La flessibilità del modello conta quando i dati sono non lineari; un algoritmo senza gradienti può funzionare, ma richiede attenzione alla stabilità; una metrica di classificazione va interpretata insieme agli errori e ai costi computazionali.
VUOI APPROFONDIRE?
Dal racconto agli esperimenti.
Questa pagina presenta le intuizioni e i risultati principali. Su GitHub trovi il codice, i report delle sette domande, le figure riproducibili, i test e le scelte metodologiche.